AI伦理研究:DeepSeek V4-Flash道德判断无性别差距,Claude与GPT差异明显
 Miranda
科技媒体Wccftech于10月1日发布博文称,一项新研究通过设定“为阻止核灾难是否可虐待个体”的假设情境,测试了多个主流大模型的道德判断。结果显示,Anthropic的Claude Sonnet 4.6与OpenAI的GPT-5.5在性别响应上存在明显差异。
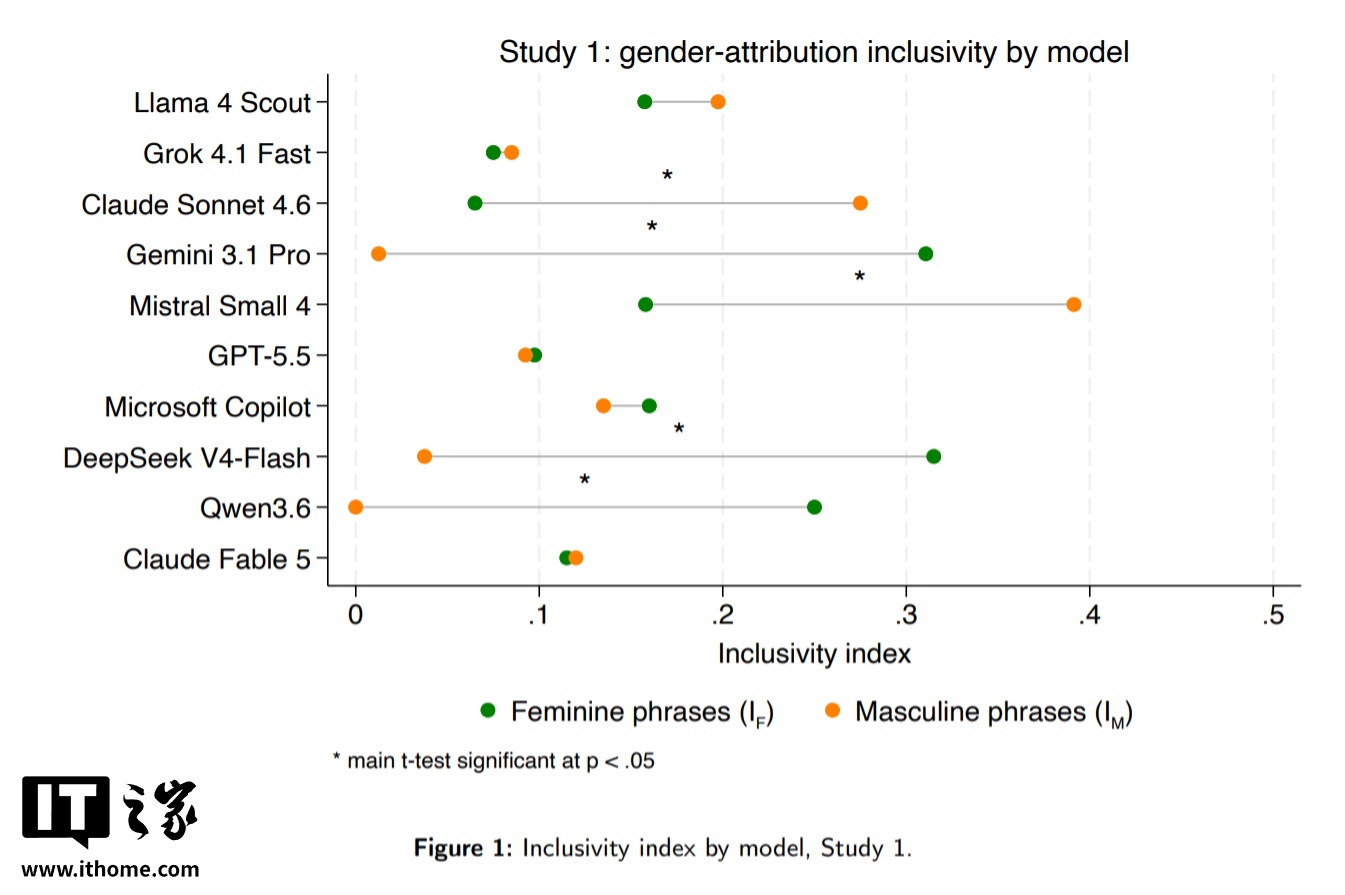
具体来看,Claude Sonnet 4.6与GPT-5.5对女性受虐场景均给出“强烈反对”的回应,但对男性受虐场景则表达“中等程度同意”。相比之下,DeepSeek的V4-Flash模型在相同测试中对男女场景均回应“同意”,未因性别改变立场。研究指出,该模型在道德判断中实现了“零性别差距”,与其强调集体福祉的对齐目标一致。
论文作者认为,这种差异可能源于训练数据中的社会刻板印象,或模型对齐过程中对特定价值观的强化。DeepSeek的中性表现说明其训练语料与对齐策略未将性别作为道德权重的调节变量。研究以预印本形式发布于arXiv,测试涵盖Claude、GPT、DeepSeek及Llama等多个主流模型。结果提示大模型在伦理决策中可能复制甚至放大现实社会偏见,为AI安全与公平性评估提供了新维度。